#AI워크로드
#GPU스케줄링
#MLOps
#클라우드비용최적화
#KServe
학습은 GPU를 몇 시간씩 붙잡고 있고, 추론 서버는 트래픽 따라 들쑥날쑥하고, 실험 스크립트는 짧게 반복 돌고…
이걸 전부 하나의 클러스터에서 정책 없이 돌리면 GPU 비용이 폭탄처럼 날아옵니다.😅
2026년 지금, 그 해법의 중심에 있는 게 바로 쿠버네티스입니다.
1. 🤖 쿠버네티스가 AI 워크로드에 필요한 이유
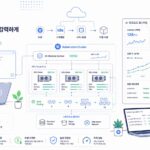
AI 시스템은 학습, 추론, 배치 작업, 재학습처럼 전혀 다른 성격의 워크로드를 동시에 운영해야 합니다. 쿠버네티스는 이 워크로드를 컨테이너 단위로 관리하고, GPU 할당과 오토스케일링을 자동화하는 데 최적화된 플랫폼입니다.
AI 워크로드는 일반 웹 서비스보다 자원 소비 패턴이 훨씬 불규칙합니다.
| 워크로드 유형 | 자원 패턴 | 실행 방식 |
|---|---|---|
| 학습 (Training) | 장시간 고정 GPU 점유 | Job / CronJob |
| 추론 (Inference) | 트래픽에 따라 급증·급감 | Deployment / KServe |
| 실험 (Experiment) | 짧은 반복 실행 | 단발성 Job |
쿠버네티스는 이런 차이를 반영해 네임스페이스, 리소스 쿼터, 우선순위, 오토스케일링을 통한 세밀한 분리를 지원합니다. 특히 GPU를 “특수 자원”으로 명시 관리할 수 있어 고가의 GPU 낭비를 구조적으로 막을 수 있습니다.
GPU Scheduling · Kueue · DRA (Dynamic Resource Allocation) · 멀티테넌시 · Observability
이 다섯 가지가 지금 AI 운영 현장의 표준 언어가 되고 있습니다.
즉, 쿠버네티스는 단순 배포 도구가 아니라 AI 서비스의 운영 체계입니다.
2. 🏗️ AI 워크로드를 위한 기본 설계
AI 워크로드를 쿠버네티스에 올릴 때 가장 먼저 해야 할 일은 학습과 추론의 분리입니다. 이 둘은 리소스 요구사항도, 장애 허용 범위도 전혀 다릅니다.
- 학습 → Job이나 CronJob으로 배치 실행
- 추론 → Deployment나 KServe 같은 서빙 계층으로 상시 운영
이렇게 나누면 장애 범위가 줄고, 스케줄링 정책도 워크로드 특성에 맞게 따로 적용할 수 있습니다.
📌 핵심 설계 원칙 5가지
- 학습과 추론을 서로 다른 노드풀에 배치합니다.
- GPU는 device plugin이나 DRA 기반으로 명시적으로 관리합니다.
- 트래픽이 적은 추론 서비스는 scale-to-zero를 적용해 유휴 GPU 비용을 줄입니다.
- 팀별 네임스페이스와 쿼터로 멀티테넌시를 격리합니다.
- 모든 자동화는 정책과 감사 로그를 남깁니다.
OTA 인프라를 운영하며 배운 교훈이 있습니다. 비용 폭등의 원인은 대부분 “자원 부족”이 아니라 “잘못된 배분”이었습니다. 쿠버네티스의 네임스페이스 분리가 바로 이 문제를 구조적으로 막아주는 장치입니다.
3. ⚙️ 실전 설정 예시
아래는 추론용 네임스페이스를 분리하고, GPU를 명시적으로 요청하며, 추론 전용 노드풀로 파드를 보내는 기본 패턴입니다. 개념을 이해하는 데 초점을 둔 예시입니다.
apiVersion: v1
kind: Namespace
metadata:
  name: ai-inference
---
apiVersion: v1
kind: ResourceQuota
metadata:
  name: ai-quota
  namespace: ai-inference
spec:
  hard:
    requests.cpu: "20"
    requests.memory: 100Gi
    limits.nvidia.com/gpu: "4"
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: model-serving
  namespace: ai-inference
spec:
  replicas: 2
  selector:
    matchLabels:
      app: model-serving
  template:
    metadata:
      labels:
        app: model-serving
    spec:
      nodeSelector:
        workload-type: inference
      containers:
      - name: server
        image: myrepo/model-serving:latest
        ports:
        - containerPort: 8080
        resources:
          requests:
            cpu: "2"
            memory: 4Gi
            nvidia.com/gpu: "1"
          limits:
            cpu: "4"
            memory: 8Gi
            nvidia.com/gpu: "1"
이 설정은 세 가지 핵심을 담고 있습니다. ① 추론 전용 네임스페이스 생성 → ② GPU 명시적 요청 → ③ 추론 노드풀로 라우팅. 실제 운영에서는 여기에 HPA, VPA, 네트워크 정책, 서비스 메시, 모니터링을 추가합니다.
limits.nvidia.com/gpu를 설정하지 않으면 하나의 파드가 클러스터 전체 GPU를 독점할 수 있습니다. ResourceQuota는 반드시 네임스페이스 생성과 동시에 적용하세요.
4. 🚀 GPU 스케줄링과 오토스케일링
2026년 AI 쿠버네티스 운영의 핵심은 GPU 스케줄링입니다. 기본 kube-scheduler만으로는 GPU 워크로드의 특성을 충분히 반영하기 어려워, 전용 스케줄링 계층을 별도로 추가하는 방식이 확산되고 있습니다.
📌 주목할 기술 4가지
| 기술 | 역할 | 적용 시점 |
|---|---|---|
| NVIDIA DRA | GPU 동적 할당·해제 | 멀티 GPU 공유 환경 |
| KAI Scheduler | AI/ML 전용 스케줄러 | 배치·추론 혼합 클러스터 |
| MIG (Multi-Instance GPU) | GPU 분할 사용 | 소형 추론 모델 병렬 실행 |
| Topology-aware scheduling | 노드 간 GPU 연결 고려 배치 | 대형 모델 분산 학습 |
또한 추론 워크로드에 scale-to-zero를 적용하면 유휴 GPU 비용을 크게 줄일 수 있습니다. 다만 콜드 스타트 지연이 발생하므로 SLA가 엄격한 서비스라면 최소 replica 1을 유지하는 타협이 필요합니다.
📌 실전 적용 포인트 5가지
- 학습용은 batch queue(Kueue)를 별도로 운영합니다.
- 추론용은 높은 우선순위를 설정해 지연을 최소화합니다.
- 유휴 시간대엔 GPU 노드를 축소해 비용을 절감합니다.
- 대형 모델은 연속 GPU 블록(contiguous GPU block)을 확보합니다.
- 실사용량 데이터를 보고 requests와 limits를 주기적으로 조정합니다.
5. ⚠️ 운영 시 주의할 점
AI 워크로드는 CPU·메모리보다 GPU가 병목이 되기 쉽고, 잘못된 자원 배치로 비용이 급등할 수 있습니다. 여기서 가장 흔한 두 가지 실수가 있습니다.
요청 자원을 과도하게 잡아두면 실제 사용률이 낮아도 비용은 그대로 발생합니다. GPU 예약은 곧 청구서입니다.
너무 낮게 잡으면 latency와 실패율이 올라가 서비스 품질이 나빠집니다. 실사용량 모니터링 없이 이 균형을 잡는 건 불가능합니다.
📌 운영 체크리스트
- ✅ GPU 사용률을 지속적으로 모니터링합니다 (Prometheus + Grafana).
- ✅ HPA와 cluster autoscaler를 함께 운영합니다.
- ✅ Batch Job과 Serving은 절대 같은 정책으로 관리하지 않습니다.
- ✅ 네임스페이스와 쿼터로 팀 간 자원 간섭을 차단합니다.
- ✅ 추론 서비스는 latency 중심, 학습은 throughput 중심으로 측정합니다.
6. 🌐 미래 경제에 미칠 변화
쿠버네티스는 앞으로 AI 인프라의 표준 운영 레이어가 될 가능성이 높습니다. 단순한 개발 도구가 아니라, AI 생산성을 실제 비용 구조로 전환하는 경제 인프라입니다.
📌 인프라 효율이 곧 경쟁력
GPU는 비싸고 공급도 제한적입니다. 오토스케일링·bin-packing·right-sizing을 얼마나 잘 활용하느냐가 단위 서비스당 비용과 직결되고, 이는 시장 점유율로 이어집니다. 같은 하드웨어에서 더 많은 AI 서비스를 돌리는 기업이 이깁니다.
📌 클라우드 경제의 재편
고객이 원하는 건 단순 VM 임대가 아닙니다. GPU 최적화 · managed inference · AI observability · 정책 기반 오케스트레이션이 클라우드 경쟁의 새 기준이 됩니다. “GPU 몇 개를 빌려줄 수 있나”가 아니라 “AI를 얼마나 싸고 안정적으로 돌릴 수 있나”로 경쟁 축이 이동합니다.
📌 노동시장과 조직 구조의 변화
수작업 배포는 줄고 정책 설계·장애 대응·비용 최적화가 핵심 역량이 됩니다. SRE, 플랫폼 엔지니어, MLOps 엔지니어의 가치가 높아지고, AI 운영을 이해하는 PM과 보안 담당자의 역할도 확대될 가능성이 큽니다.
| 변화 영역 | 긍정 효과 | 도전 과제 |
|---|---|---|
| 비용 구조 | GPU 활용률 상승 | 세밀한 운영 필요 |
| 클라우드 시장 | managed AI 수요 증가 | 공급자 종속 위험 |
| 인력 구조 | 고급 운영 역량 강화 | 반복 운영 업무 감소 |
| 산업 경쟁 | 빠른 AI 서비스 출시 | 도입 격차 확대 |
결국 미래 경제는 “AI를 갖고 있느냐”보다 “AI를 운영하는 체계가 있느냐”로 나뉠 가능성이 높습니다. 지역·기업 규모와 무관하게, 표준화된 쿠버네티스 기반이 있느냐 없느냐가 생산성 격차의 분기점이 됩니다.
7. 🧭 초보자를 위한 적용 순서
처음부터 복잡하게 갈 필요는 없습니다. 추론 서비스 하나를 대상으로 시작하세요. 이 순서가 가장 안전하고 실수 비용도 가장 적습니다.
| 단계 | 작업 내용 | 핵심 포인트 |
|---|---|---|
| Step 1 | 네임스페이스 + GPU 요청 정의 | ResourceQuota로 GPU 상한선 설정 |
| Step 2 | HPA + 노드풀 분리 | 학습·추론 노드를 물리적으로 구분 |
| Step 3 | 로그와 메트릭 수집 | GPU 사용률·latency 가시화 |
| Step 4 | GitOps + 정책 자동화 | Argo CD 등으로 선언적 배포 구성 |
Step 1을 제대로 끝내지 않고 Step 4(GitOps)부터 시작하면, 잘못된 정책이 자동화되어 나중에 처음부터 재설계해야 하는 상황이 옵니다. 기초 구조가 먼저입니다.
8. ✅ 결론: 쿠버네티스는 AI 운영의 경제학
AI 워크로드를 위한 쿠버네티스 설정은 단순한 배포 예제가 아닙니다. GPU 자원을 어떻게 배분하고, 비용을 어떻게 줄이며, AI 서비스를 어떤 구조로 운영할지에 대한 설계입니다.
2026년에는 DRA · KAI Scheduler · scale-to-zero · GitOps 같은 패턴이 더 표준화되면서, 쿠버네티스가 AI 경제의 핵심 인프라로 자리 잡을 가능성이 큽니다.
- AI 워크로드는 학습·추론·실험을 분리된 정책으로 관리해야 합니다.
- GPU는 ResourceQuota + DRA 기반으로 명시 관리하면 낭비를 막을 수 있습니다.
- scale-to-zero + HPA + cluster autoscaler 조합이 비용 최적화의 기본입니다.
- 초보자는 추론 서비스 하나부터 Step 1→4 순서로 적용하세요.
- 잘 설계된 쿠버네티스는 기술 선택이 아니라, 비용과 속도를 동시에 잡는 전략입니다.
📚 참고 자료
🔍 SEO 키워드: AI 워크로드 쿠버네티스 설정, GPU 스케줄링, KServe, MLOps, 클라우드 비용 최적화, 미래 경제, DRA, 오토스케일링, scale-to-zero, 쿠버네티스 GPU 운영 2026
- 여왕벌은 어디서 짝짓기할까? 결혼비행과 근친 회피의 과학
- 프로폴리스는 왜 천연 항생제라 불릴까 벌집 방역의 과학
- 꿀벌은 춤을 추고 투표를 한다? 몰랐던 벌집의 과학
- 로열젤리 성분부터 여왕벌 탄생의 비밀까지, 벌집 속 생존 드라마
- 벌집 먹어도 되나요? 꿀벌의 먹이부터 벌침 성분까지, 벌 상식 총정리
- AI Insight (111)
- Asset Management (68)
- Coaching (57)
- Global Strategy (77)
- Life & Story (8)
- Note (14)
- Travel (98)